Un modèle qui prédit la réussite des apprenants s’appuie sur les données de promotions précédentes. Il apprend quelles caractéristiques et quels comportements étaient associés à la réussite ou à l’échec. Si certains groupes réussissaient moins bien, pour des raisons sociales, économiques ou matérielles, le modèle risque de les signaler systématiquement comme « à risque ».
D’où viennent les biais ?
Baker et Hawn (2022) ont proposé une revue de la littérature sur les biais algorithmiques en éducation. Ils montrent que ces biais peuvent apparaître à plusieurs étapes : dans les données utilisées, dans la manière de mesurer les variables, dans la construction du modèle, et dans l’usage des prédictions.
Le biais ne vient donc pas de l’algorithme seul, mais de l’histoire inscrite dans les données et des choix faits par ceux qui le conçoivent.
Des effets bien réels
O’Neil (2016) a décrit comment des modèles opaques, déployés à grande échelle et difficiles à contester, peuvent renforcer les inégalités qu’ils prétendent mesurer. En éducation, un signal « à risque » peut avoir des effets concrets : moins d’attentes envers ces apprenants, une orientation différente, une stigmatisation.
Le cas des détecteurs de textes générés par l’IA en est une illustration récente : une étude a montré qu’ils classaient plus souvent à tort comme générés par une machine les textes rédigés par des personnes écrivant dans une langue seconde (Liang et al., 2023).
Quelques précautions
Pour limiter ces risques, plusieurs précautions s’imposent :
- vérifier les performances du modèle séparément pour différents groupes d’apprenants ;
- se demander quelles variables sont utilisées, et si elles reflètent des inégalités plutôt que des comportements d’apprentissage ;
- présenter les prédictions comme des probabilités, avec leurs marges d’erreur ;
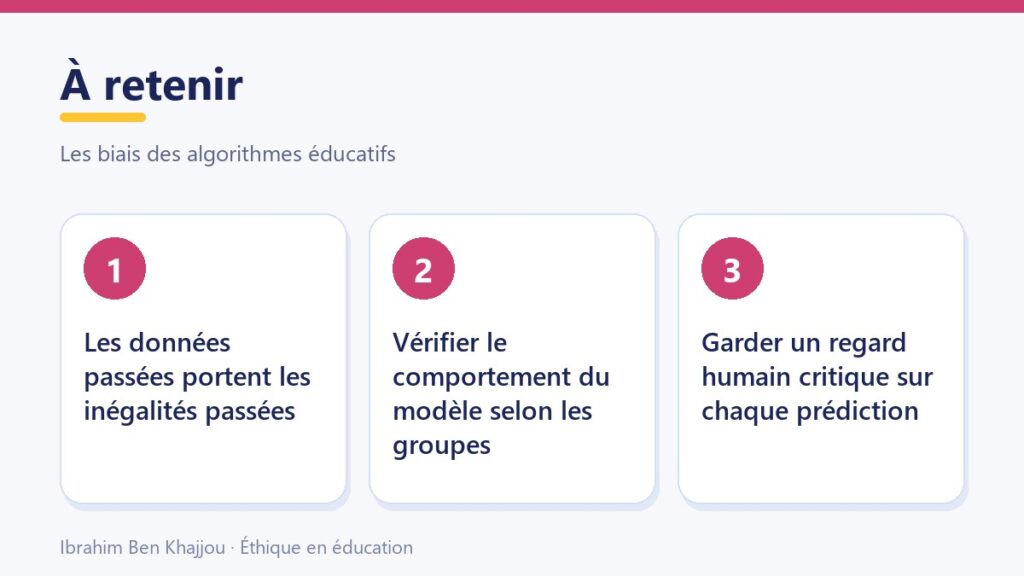
- garder un regard humain critique sur chaque prédiction ;
- permettre aux apprenants de contester une décision qui les concerne.
Un algorithme qui reproduit le passé ne peut pas, seul, construire un avenir plus juste.
Une responsabilité partagée
La lutte contre les biais n’est pas seulement une affaire de techniciens. Elle concerne aussi les enseignants, les responsables pédagogiques et les institutions, qui décident d’utiliser ou non ces outils et de la manière de les utiliser.
Un exemple concret
Un établissement utilise un modèle prédictif pour identifier les étudiants à risque d’échec. En analysant ses performances, l’équipe constate que le modèle signale beaucoup plus souvent les étudiants boursiers, y compris ceux qui réussissent ensuite très bien.
En examinant les variables utilisées, elle découvre que plusieurs d’entre elles sont liées aux conditions de vie : horaires de connexion tardifs, connexions depuis un téléphone, interruptions d’activité pendant les périodes de travail salarié. Le modèle confondait contraintes matérielles et difficultés d’apprentissage.
L’équipe retire certaines variables, présente désormais les prédictions comme de simples signaux à vérifier, et vérifie régulièrement les performances du modèle selon les groupes d’étudiants.
Ce que cela change pour l’évaluation
L’évaluation d’un dispositif qui utilise des prédictions doit inclure une analyse des biais : les erreurs du modèle sont-elles réparties de manière équitable ? Certaines catégories d’apprenants sont-elles plus souvent mal classées ?
Cette analyse n’est pas réservée aux spécialistes des données. Les enseignants et les responsables pédagogiques peuvent poser ces questions et exiger des réponses des concepteurs. Le principe de justice figure d’ailleurs parmi les principes éthiques fondamentaux proposés pour l’IA par Floridi et Cowls (2019) : il implique d’éviter les discriminations et de partager équitablement les bénéfices.
En conclusion
Les algorithmes éducatifs apprennent du passé et peuvent en reproduire les inégalités. Vérifier leur comportement selon les groupes, examiner les variables utilisées, présenter les prédictions avec prudence et garder un regard humain critique sont des précautions indispensables pour qu’ils servent l’équité plutôt que de la compromettre.
Et vous ? Les outils prédictifs utilisés dans votre établissement ont-ils été évalués pour leurs biais ?
Références
- Baker, R. S., et Hawn, A. (2022). Algorithmic bias in education. International Journal of Artificial Intelligence in Education, 32(4), 1052–1092.
- Floridi, L., et Cowls, J. (2019). A unified framework of five principles for AI in society. Harvard Data Science Review, 1(1).
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., et Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779.
- O’Neil, C. (2016). Weapons of math destruction: How big data increases inequality and threatens democracy. Crown.
Laisser un commentaire